
目前我們有三台 Node:
kubectl get nodes
應該會看到類似:
cka-lab-control-plane
cka-lab-worker
cka-lab-worker2
但是有一件事情我們一直沒有控制。
假設建立:
replicas: 3
三個 API Pod 到底會跑去哪裡?
我們之前都是:
Kubernetes 你自己決定。
今天第一次開始控制 Scheduler。
建立 Pod 時,一開始它其實還沒有 Node。
可以把過程想成:
Pod 被建立
     │
     ▼
目前沒有 Node
     │
     ▼
Scheduler 開始找候選 Node
     │
     ├── CPU 夠嗎?
     ├── RAM 夠嗎?
     ├── Label 符合嗎?
     ├── Taint 可以接受嗎?
     ├── Affinity 符合嗎?
     └── 其他 Scheduling 條件
     │
     ▼
選出 Node
這邊你可能會好奇
在 Kubernetes 中,剛建立的 Pod 並不是一個「正在執行的實體進程」,而是一筆寫入 etcd 的狀態宣告(YAML 定義資料)。
這正是 Kubernetes 採用宣告式架構(Declarative Model)與控制迴圈(Reconciliation Loop)的核心設計。
當你執行 kubectl apply -f pod.yaml 時:
etcd。Pending,且規格中的 spec.nodeName 欄位為空("")。如果要求「必須先找到 Node 才能建立 Pod」,會讓系統陷入強耦合與效能瓶頸:
解耦與單一職責(Decoupling):
狀態一致性保證:
支援進階排隊與調度策略:
| 階段 | 負責組件 | 行為與狀態變化 |
|---|---|---|
| 1. 接收與記錄 | kube-apiserver |
寫入 etcd,此時 spec.nodeName 為空,狀態為 Pending。 |
| 2. 監聽與決策 | kube-scheduler |
監聽發現尚未綁定節點的 Pod,計算合適節點(Filtering & Scoring)。 |
| 3. 綁定(Binding) | kube-scheduler |
發送 Binding 請求給 API Server,將 Pod 的 spec.nodeName 改為目標節點名稱。 |
| 4. 實體啟動 | 目標節點的 kubelet |
監聽到有指定給自己的 Pod,透過容器運行時(Containerd/CRI)拉取鏡像檔並真正啟動容器。 |
這種「先記錄意圖,再由專責控制器逐步收斂至目標狀態」的機制,正是 Kubernetes 具備高擴展性與彈性的核心基石。
所以 Scheduler 不是「執行 Pod」。
它主要是在回答:
這個 Pod 最適合去哪台 Node?
真正讓 Container 跑起來的仍然是那台 Node 上的 kubelet。
把 API Scaling 成三份:
kubectl scale deployment/api \
  --replicas=3 \
  -n cka-lab
然後:
kubectl get pods \
  -n cka-lab \
  -o wide
-o wide 會多顯示:
IP
NODE
你會看到:
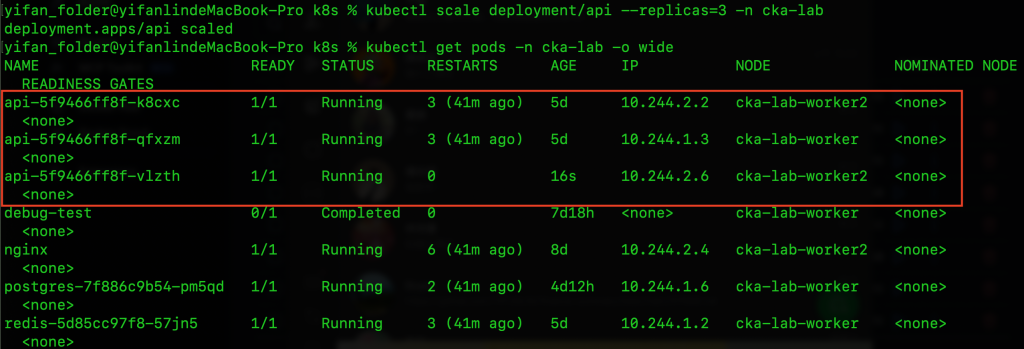
Scheduler 已經默默幫我們做了決策。
我們在 Day 6 已經用過:
app=api
這種 Pod Label。
其實 Node 也可以有 Label。
先:
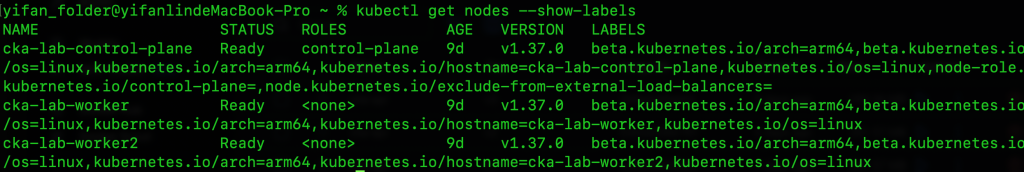
kubectl get nodes --show-labels
會看到非常多 Kubernetes 自己加上的 Label。
現在假裝:
cka-lab-worker
是一台配有 SSD 的高效能機器。
執行:
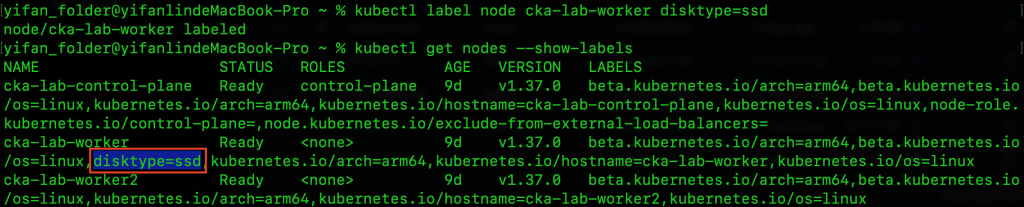
kubectl label node \
  cka-lab-worker \
  disktype=ssd
再:
kubectl get nodes --show-labels
你會看到:
disktype=ssd
所以 Label 的概念完全一樣:
Node
+
Metadata
+
disktype=ssd
Deployment 的 Pod Template 可以加入:
spec:

  nodeSelector:
    disktype: ssd

  containers:
    - name: api
      image: cka-api:v3
意思就是:
這個 Pod 只能被排到具有
disktype=ssdLabel 的 Node。
因此:
Pod
nodeSelector:
disktype=ssd

        │
        ▼

Scheduler 尋找 Node

worker
disktype=ssd
        │
        ▼
      Match
如果 worker2 沒這個 Label:
worker2
沒有 disktype=ssd
Scheduler 就不會選它。
更新 Deployment 後:
kubectl rollout restart \
  deployment/api \
  -n cka-lab
套用本地 YAML 更新:將修改同步至 etcd。執行套用指令,將你剛才在 01-api.yaml 新增的 nodeSelector 送入 API Server:
kubectl apply -f 01-api.yaml -n cka-lab
再:
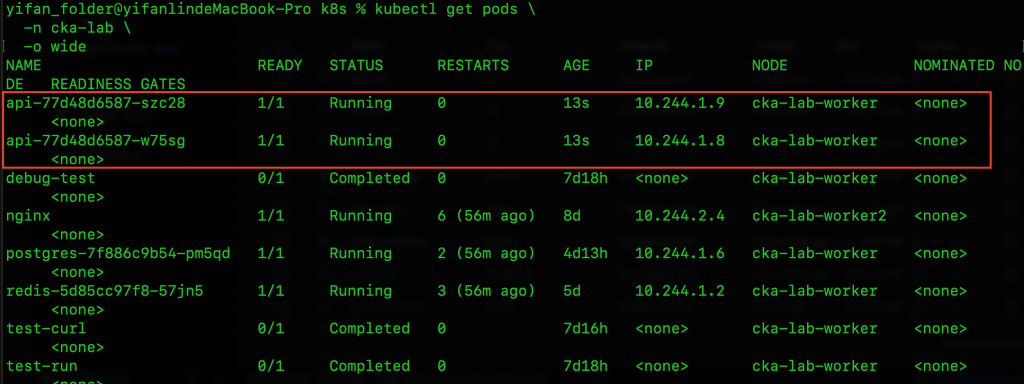
kubectl get pods \
  -n cka-lab \
  -o wide
你應該會發現新 API Pod 全部跑到:
cka-lab-worker
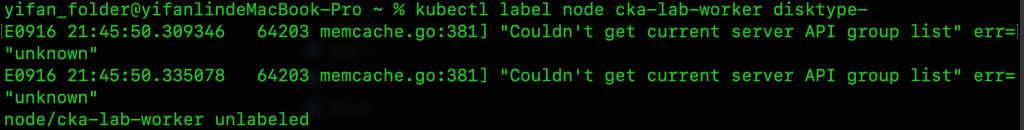
把 Node Label 移除:
kubectl label node \
  cka-lab-worker \
  disktype-
最後面的:
-
代表:
移除這個 Label。
然後重新:
kubectl rollout restart \
  deployment/api \
  -n cka-lab
看:
kubectl get pods -n cka-lab
新的 Pod 很可能:
Pending
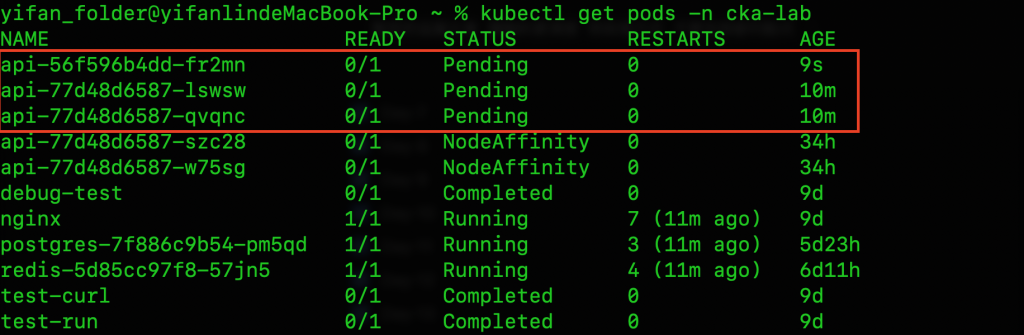
這是今天第一個重要故障。
因為 Pod 還沒真正開始。
所以:
kubectl describe pod POD_NAME \
  -n cka-lab
看最下面:
Events
看到:
0/3 nodes are available
didn't match Pod's node affinity/selector
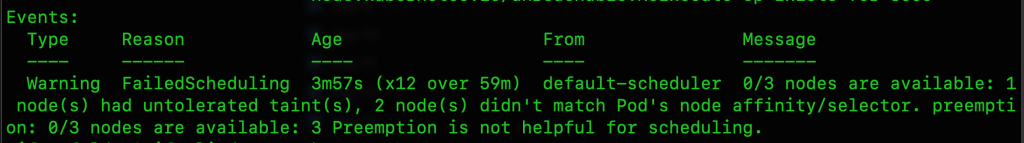
這就是 Scheduler 在告訴你:
我不是不想排,是沒有任何 Node 符合你的規則。
修復:
kubectl label node \
  cka-lab-worker \
  disktype=ssd
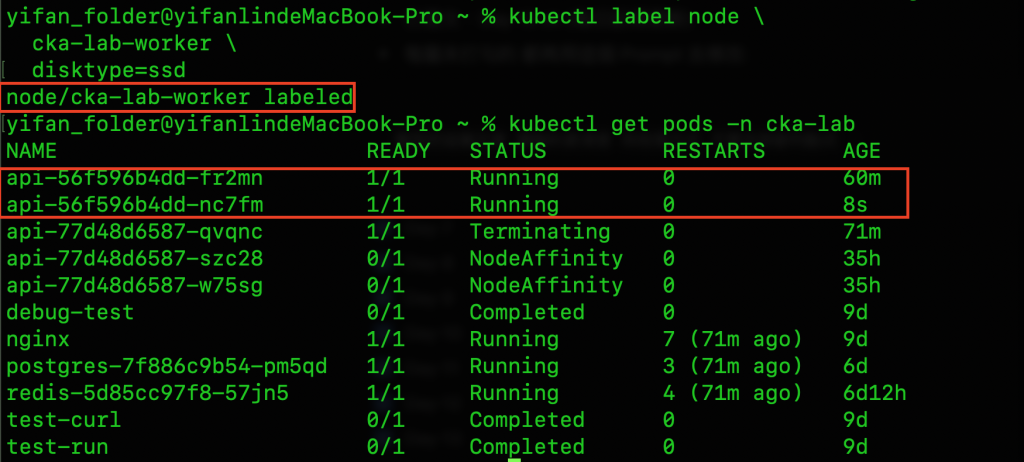
Pod 就能繼續 Scheduling。
前面學 nodeSelector 的時候,我們是在處理一件事情:
Pod 想去哪一台 Node。
但今天的 Taint,方向剛好相反。
它處理的是:
Node 願不願意讓這個 Pod 進來。
如果把 Kubernetes Scheduling 想成找房子,nodeSelector 比較像房客挑房子,而 Taint 則比較像房東在門口設限制。
Taint 是設定在 Node 上的一種排程限制,用來阻止不符合條件的 Pod 被 Scheduler 安排到這台 Node。
你可以先把它理解成:
Node 在自己身上貼一張「限制進入」的告示。
例如執行:
kubectl taint node \
  cka-lab-worker \
  dedicated=api:NoSchedule
這代表在:
cka-lab-worker
這台 Node 上加入:
dedicated=api:NoSchedule
這個 Taint。
白話可以理解成:
這台 Node 有特殊用途,不要讓一般 Pod 隨便排進來。
所以 Taint 最核心的概念就是:
Taint
=設定在 Node 上的排程限制
=Node 主動排斥某些 Pod
它和 nodeSelector 最大的差別,就是控制方向不同。
nodeSelector 是:
Pod → Node
Pod 說:
我要找什麼樣的 Node。
而 Taint 是:
Node → Pod
Node 說:
哪些 Pod 不可以隨便來。
我們剛剛加入的是:
dedicated=api:NoSchedule
一個 Taint 通常可以拆成:
key=value:effect
所以這裡:
dedicated
是 key,
api
是 value,
而:
NoSchedule
是 effect。
可以把它看成:
dedicated = api : NoSchedule
    │        │         │
    │        │         └── 要產生什麼排程效果
    │        └──────────── 這個 Taint 的值
    └───────────────────── 這個 Taint 的名稱
真正決定 Scheduler 怎麼處理 Pod 的,是最後面的:
Effect
NoSchedule 是最常見的 Taint Effect 之一。
它代表:
如果一個新的 Pod 沒有對應的 Toleration,就不要把它排到這台 Node。
例如:
worker
Taint:
dedicated=api:NoSchedule
這時如果有一個普通 Pod 想進來,但它沒有相對應的 Toleration,Scheduler 就會拒絕把它安排到這台 Node。
可以想成:
Pod
 │
 │ 想進去
 ▼

worker
dedicated=api:NoSchedule

🚫 不准進
這裡有一個很重要的細節。
假設 API Pod 原本已經跑在:
cka-lab-worker
這時你才加入:
dedicated=api:NoSchedule
通常原本已經在這台 Node 上 Running 的 Pod 不會因此被趕走。
因為:
NoSchedule
主要影響的是:
新的 Scheduling
也就是之後新建立的 Pod。
所以你可能執行完:
kubectl taint node \
  cka-lab-worker \
  dedicated=api:NoSchedule
之後發現:
API Pod 還是 Running
這是正常的。
不是 Taint 沒有效果,而是這顆 Pod 已經完成排程了。
如果我們想真的看到 Taint 的效果,就需要讓 Kubernetes 建立新的 Pod。
所以可以執行:
kubectl rollout restart \
  deployment/api \
  -n cka-lab
Deployment 會建立新的 API Pod。
這顆新 Pod 出現之後,Scheduler 就必須重新思考:
我要把這顆 Pod 放在哪一台 Node?
這時 Taint 才會真正參與排程判斷。
假設你的 API Deployment 原本就有:
nodeSelector:
  disktype: ssd
而只有:
cka-lab-worker
這台 Node 有:
disktype=ssd
那代表 API Pod 已經先提出一個要求:
我只能去具有
disktype=ssd的 Node。
Scheduler 找了一圈之後發現:
control-plane
沒有 disktype=ssd
→ 不符合

worker
有 disktype=ssd
→ 符合
所以從 nodeSelector 的角度來看:
API Pod 只能去 worker。
但現在 worker 又被我們加上:
dedicated=api:NoSchedule
問題就出現了。
API Pod 雖然「想去」worker,但是 worker 又說:
沒有通行資格的 Pod 不准進。
所以現在狀況會變成:
API Pod
因為 nodeSelector
只能去 worker

但是 worker
有 Taint

而 Pod
沒有 Toleration
最後結果就是:
想去
+
不能進
=
Pending
Scheduler 在替 Pod 找 Node 時,不是只檢查一個條件。
它會檢查:
Node Label 是否符合?
也會檢查:
nodeSelector 是否符合?
還會檢查:
Node 上的 Taint,Pod 是否能接受?
所以即使:
nodeSelector
✅ 符合
如果:
Taint / Toleration
❌ 不符合
這台 Node 還是不能使用。
在我們這個例子裡:
worker
雖然符合:
disktype=ssd
但是它又有:
dedicated=api:NoSchedule
而 API Pod 沒有通行資格。
另外一台 Node 又不符合 nodeSelector。
因此 Scheduler 最後找不到任何可用 Node。
Pod 就只能停在:
Pending
要解決這個問題,就需要:
Toleration
Toleration 是設定在 Pod 上的排程條件,用來表示這個 Pod 可以接受某個 Taint。
可以把它理解成:
Pod 身上的通行證。
例如 Node 有:
dedicated=api:NoSchedule
那 Deployment 可以加入:
spec:
  template:
    spec:
      nodeSelector:
        disktype: ssd

      tolerations:
        - key: dedicated
          operator: Equal
          value: api
          effect: NoSchedule
這段代表:
我的 Pod 可以容忍
dedicated=api:NoSchedule這個 Taint。
這時 Scheduler 再來判斷:
nodeSelector:
disktype=ssd
worker 符合。
接著看到:
worker
Taint:
dedicated=api:NoSchedule
Scheduler 再去檢查 Pod:
有沒有對應的 Toleration?
現在答案是:
有。
因此這個 Taint 就不再阻止 API Pod。
Pod 就可以正常被排到 worker。
這裡是非常容易搞錯的地方。
很多人會看到:
Toleration
就以為:
有 Toleration,所以 Pod 就會被安排到這台有 Taint 的 Node。
其實不是。
Toleration 只代表:
這個 Taint 不會阻止我。
它並不是:
我一定要去哪一台 Node。
例如:
worker1
Taint:
dedicated=api:NoSchedule

worker2
沒有 Taint
現在 API Pod 有:
dedicated=api:NoSchedule
的 Toleration。
那代表 worker1 從:
不能去
變成:
可以去
但是 worker2 本來就可以去。
所以最後 Scheduler 仍然可能安排:
API Pod → worker1
也可能安排:
API Pod → worker2
要看其他 Scheduling 條件。
因此要牢記:
Toleration
≠ 指定 Node
它只是:
解除某個 Taint 的阻擋。
真正用來控制「Pod 想去哪裡」的,還是 nodeSelector,或後面會學到的 Node Affinity。
可以把整個機制想成去公司上班。
假設 worker 是一棟大樓。
它身上有:
Label:
disktype=ssd
代表:
這是一棟 SSD 大樓。
API Pod 使用:
nodeSelector:
disktype=ssd
代表:
我只想去 SSD 大樓。
所以 API Pod 找到:
worker
目前沒問題。
但是 worker 門口又有:
Taint:
dedicated=api:NoSchedule
這就像門口裝了一個門禁:
沒有資格的人不能進。
如果 API Pod 沒有 Toleration:
Pod:
我想來。

Node:
你符合地點條件,但是你沒有通行證。

Pod:
那我進不去。
結果:
Pending
如果 API Pod 有:
Toleration:
dedicated=api:NoSchedule
就變成:
Pod:
我想來,而且我有通行證。

Node:
可以進。

Scheduler:
那我就把你排到這裡。
這三個概念最好一起理解,不要分開死背。
nodeSelector 是 Pod 提出的要求:
我想去哪裡。
Taint 是 Node 設定的限制:
哪些 Pod 不可以隨便來。
Toleration 則是 Pod 的回應:
你這個限制我可以接受。
所以整個排程流程可以理解成:
Pod
先用 nodeSelector 找到適合的 Node
        ↓
Node 如果有 Taint
        ↓
Scheduler 檢查 Pod 有沒有 Toleration
        ↓
有
→ 可以繼續排程

沒有
→ 不能使用這台 Node
當你看到:
Pod = Pending
代表 Pod 很可能根本還沒有成功被 Scheduler 放到任何 Node。
這時最重要的指令之一就是:
kubectl describe pod POD_NAME -n cka-lab
然後看最下面:
Events
你可能會看到類似:
0/2 nodes are available:
1 node(s) didn't match Pod's node selector,
1 node(s) had untolerated taint
白話就是:
你總共有兩台 Node。
其中一台:
不符合 Pod 的 nodeSelector。
另一台:
有一個 Pod 無法容忍的 Taint。
所以:
我找不到地方放這個 Pod。
這就是為什麼 Pod 會一直停在 Pending。
也因此看到 Pending,不要第一時間:
kubectl delete pod
因為如果 Deployment 設定完全沒變,新 Pod 建立之後還是會遇到一模一樣的 Scheduling 問題。
實驗做完之後,可以執行:
kubectl taint node \
  cka-lab-worker \
  dedicated=api:NoSchedule-
注意最後面的:
-
代表:
移除這個 Taint
所以:
dedicated=api:NoSchedule
是加入或表示這個 Taint。
而:
dedicated=api:NoSchedule-
則是在告訴 Kubernetes:
把這個 Taint 拿掉。
這一章其實不用先死背 YAML。
真正重要的是把 Scheduling 的方向搞懂。
Label
=描述 Node 有什麼特徵

nodeSelector
=Pod 說「我要去哪種 Node」

Taint
=Node 設定排程限制,阻止不符合條件的 Pod 進來

Toleration
=Pod 說「這個 Taint 我可以接受」
最值得記住的一句話是:
nodeSelector 決定「我想去哪」,
Taint 決定「你能不能進」,
Toleration 則是「我有資格通過這個限制」。
而當你看到:
Pending
第一個反射應該慢慢建立成:
kubectl describe pod POD_NAME
因為很多 Pending 問題,其實不是 Application 壞掉,而是:
Scheduler 找不到符合所有條件的 Node。
等這個觀念清楚之後,下一步再學 Node Affinity 就會順很多,因為 Affinity 本質上就是把現在比較簡單、比較絕對的 nodeSelector,變成更有彈性的 Scheduling 規則。


 iThome鐵人賽
 看影片追技術